 汤不热吧
Transformer架构深度解析:从Self-Attention到Multi-Head Attention的PyTorch完整实现指南
自2017年Google在论文《Attention Is All You Need》中提出Transformer架构以来,它已经彻底改变了自然语言处理乃至整个深度学习的格局。从BERT到GPT,从ViT到CLIP,几乎所有现代大型模型的核心...
自2017年Google在论文《Attention Is All You Need》中提出Transformer架构以来,它已经彻底改变了自然语言处理乃至整个深度学习的格局。从BERT到GPT,从ViT到CLIP,几乎所有现代大型模型的核心...

引言:为什么scipy.optimize是科学计算的瑞士军刀 在Python科学计算生态中, 1scipy.optimize 是一个常被低估的宝藏模块。无论你是在做机器学习的超参数调优、金融领域的投资组合优化、工程设计的参数拟合,还是物理仿...
在深度学习模型规模不断膨胀的今天,训练一个大型模型动辄需要数十甚至上百 GPU·天。当显存成为瓶颈、训练时间成为成本大头时,混合精度训练(Mixed Precision Training)就成了必须掌握的优化手段。它可以在几乎不损失模型精度...
在向量搜索领域,Faiss、Milvus、Qdrant 等工具早已广为人知,但 Google 开源的 ScaNN(Scalable Nearest Neighbors)却常常被低估。ScaNN 凭借独创的各向异性量化(Anisotropic...
一、引言:当模型参数放不进单卡显存时 随着大语言模型规模的不断膨胀,从 BERT-base 的 1.1 亿参数到 Llama 3 的 4050 亿参数,单张 GPU 的显存早已无法承载完整的模型训练。即便是拥有 80GB HBM3 显存的 ...
一、引言:从 RLHF 到 DPO 的范式转变 大语言模型(LLM)在预训练阶段通过海量文本学习到了丰富的语言知识和世界知识,但预训练模型的行为并不一定符合人类期望——它可能输出有害内容、编造事实,或者无法遵循指令。为了让模型”...
从传统RAG到Agentic RAG:智能代理检索增强生成系统架构设计与生产部署实战 2024年以来,检索增强生成(Retrieval-Augmented Generation, RAG)技术经历了从朴素架构到智能代理化的重要演进。传统的&...
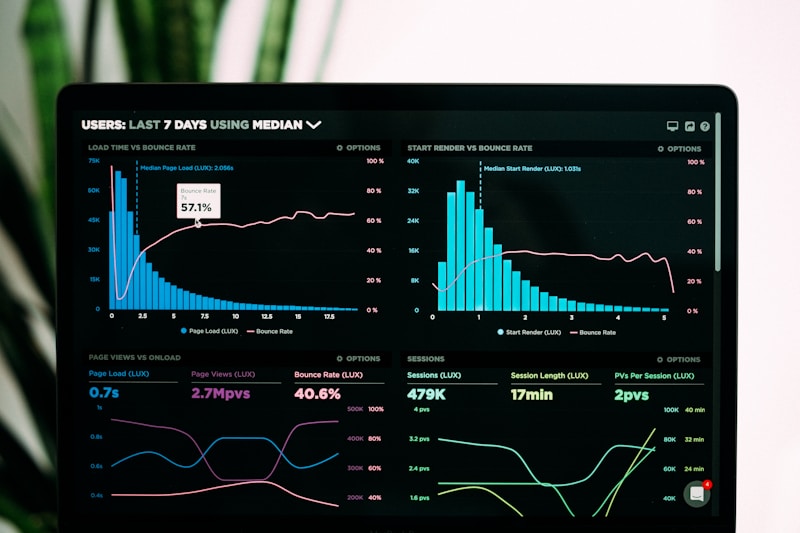
引言:为什么需要自适应查询执行? 在 Apache Spark 的早期版本中,SQL 查询的性能高度依赖于开发人员对数据的了解程度和手动调优经验。一个常见的场景是:开发者在开发环境设定了一个合理的 shuffle 分区数(如 200),但到...
引言:为什么机器学习模型需要正则化? 在机器学习实践中,我们经常会遇到这样的困境:模型在训练集上表现完美,准确率接近100%,但一旦面对全新的测试数据,性能就急剧下降。这种现象被称为过拟合(Overfitting),是机器学习中最常见也最棘...
随着大模型的体积不断增长,如何在资源受限的端侧设备上高效运行这些模型成为了关键挑战。Apple M系列芯片,特别是最新的M3系列,通过其独特的统一内存架构(Unified Memory Architecture, UMA),为端侧大模型推理...