 汤不热吧

华为昇腾适配经验:在没有 CUDA 的日子里,如何利用 CANN 调优模型性能
在脱离了熟悉的 CUDA 生态后,针对华为昇腾(Ascend)硬件进行深度学习模型推理性能优化,是许多开发者需要面临的挑战。昇腾平台的核心是 CANN(Compute Architecture for Neural Networks)工具链...
在脱离了熟悉的 CUDA 生态后,针对华为昇腾(Ascend)硬件进行深度学习模型推理性能优化,是许多开发者需要面临的挑战。昇腾平台的核心是 CANN(Compute Architecture for Neural Networks)工具链...
系统讲解大模型 PD 分离部署:Prefill 与 Decode 的资源差异、KV Cache 传输、调度策略、网络要求,以及 vLLM 和 SGLang 的选型方法。
如何优化大模型首词延迟:详解预填充阶段的量化加速技巧 在大语言模型(LLM)的部署实践中,首词延迟(Time to First Token, TTFT)是影响用户交互体验的核心指标。当用户输入较长的 Prompt 时,模型需要经历一个漫长的...
引言:为什么 torch.compile 改变了 PyTorch 的游戏规则 2023 年 PyTorch 2.0 的发布标志着 PyTorch 生态的一个重大转折点。其中最核心的新特性—— 1torch.compile ——被 PyTor...
如何通过 AclLite 封装大幅简化昇腾推理程序的开发流程 在国产昇腾(Ascend)芯片上进行 AI 推理开发时,开发者通常需要直接面对 CANN (Compute Architecture for Neural Networks) 的...
自2017年Google在论文《Attention Is All You Need》中提出Transformer架构以来,它已经彻底改变了自然语言处理乃至整个深度学习的格局。从BERT到GPT,从ViT到CLIP,几乎所有现代大型模型的核心...

引言:为什么scipy.optimize是科学计算的瑞士军刀 在Python科学计算生态中, 1scipy.optimize 是一个常被低估的宝藏模块。无论你是在做机器学习的超参数调优、金融领域的投资组合优化、工程设计的参数拟合,还是物理仿...
在深度学习模型规模不断膨胀的今天,训练一个大型模型动辄需要数十甚至上百 GPU·天。当显存成为瓶颈、训练时间成为成本大头时,混合精度训练(Mixed Precision Training)就成了必须掌握的优化手段。它可以在几乎不损失模型精度...
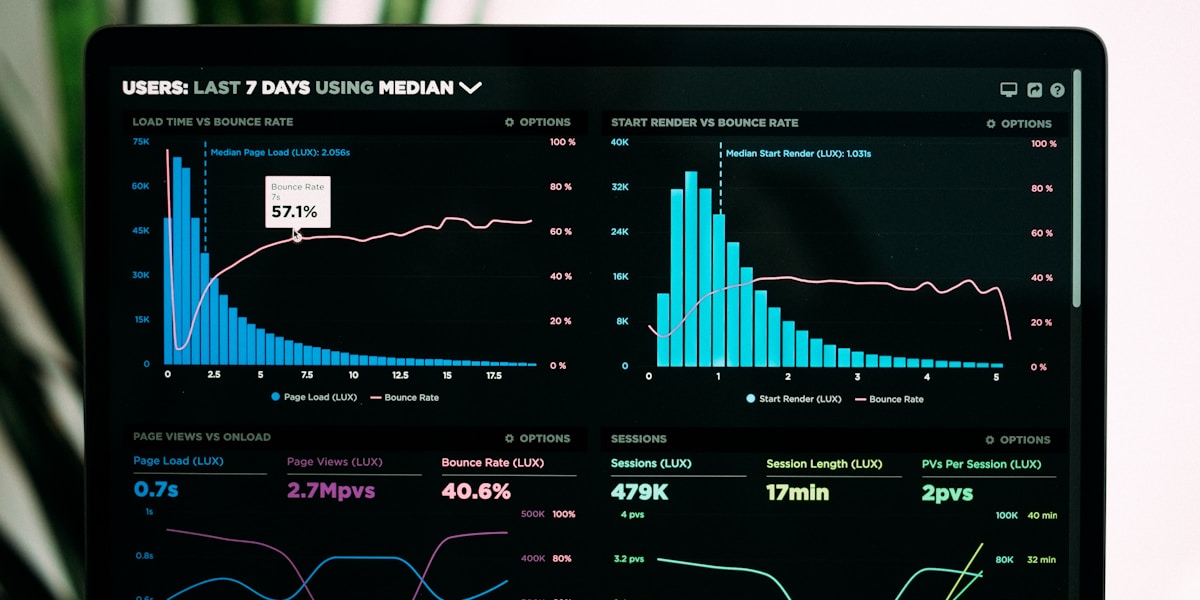
在向量搜索领域,Faiss、Milvus、Qdrant 等工具早已广为人知,但 Google 开源的 ScaNN(Scalable Nearest Neighbors)却常常被低估。ScaNN 凭借独创的各向异性量化(Anisotropic...
一、引言:当模型参数放不进单卡显存时 随着大语言模型规模的不断膨胀,从 BERT-base 的 1.1 亿参数到 Llama 3 的 4050 亿参数,单张 GPU 的显存早已无法承载完整的模型训练。即便是拥有 80GB HBM3 显存的 ...